Dadinho Drip
Do flipbook ao render com IA
Uma simulação bem simples, um dadinho de tapioca e o ComfyUI fazendo o render. Com alguns erros no meio, é claro.
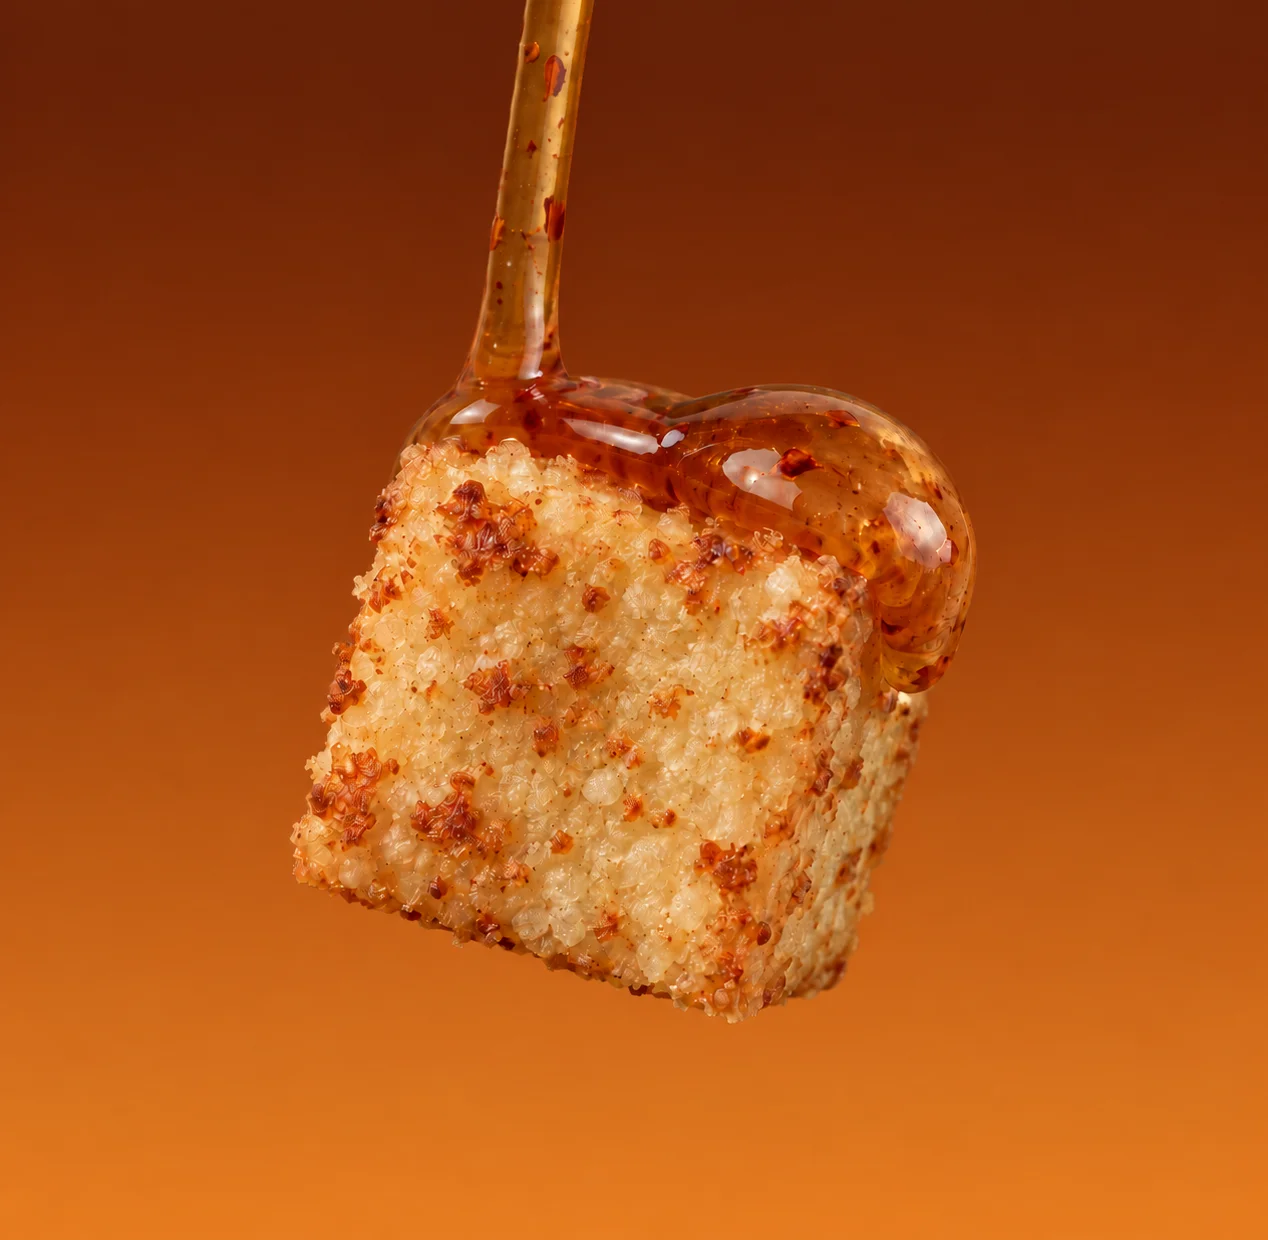
Antes de tudo, o resultado. É um vídeo simples, mas me ensinou bastante no processo.
De onde veio a ideia
Freelancer… mercado meio parado… já sabe, é hora de experimentar algumas coisas novas e de me atualizar pro que o mercado vem exigindo. É o momento de descobrir como eu me encaixo. A IA é realmente rápida? barata? Como eu posso entrar nesse mercado?
Então pra começar eu quis fazer uma coisa que eu tenho muita dificuldade e que é pesada, um render realista de fluido.
A simulação no Houdini
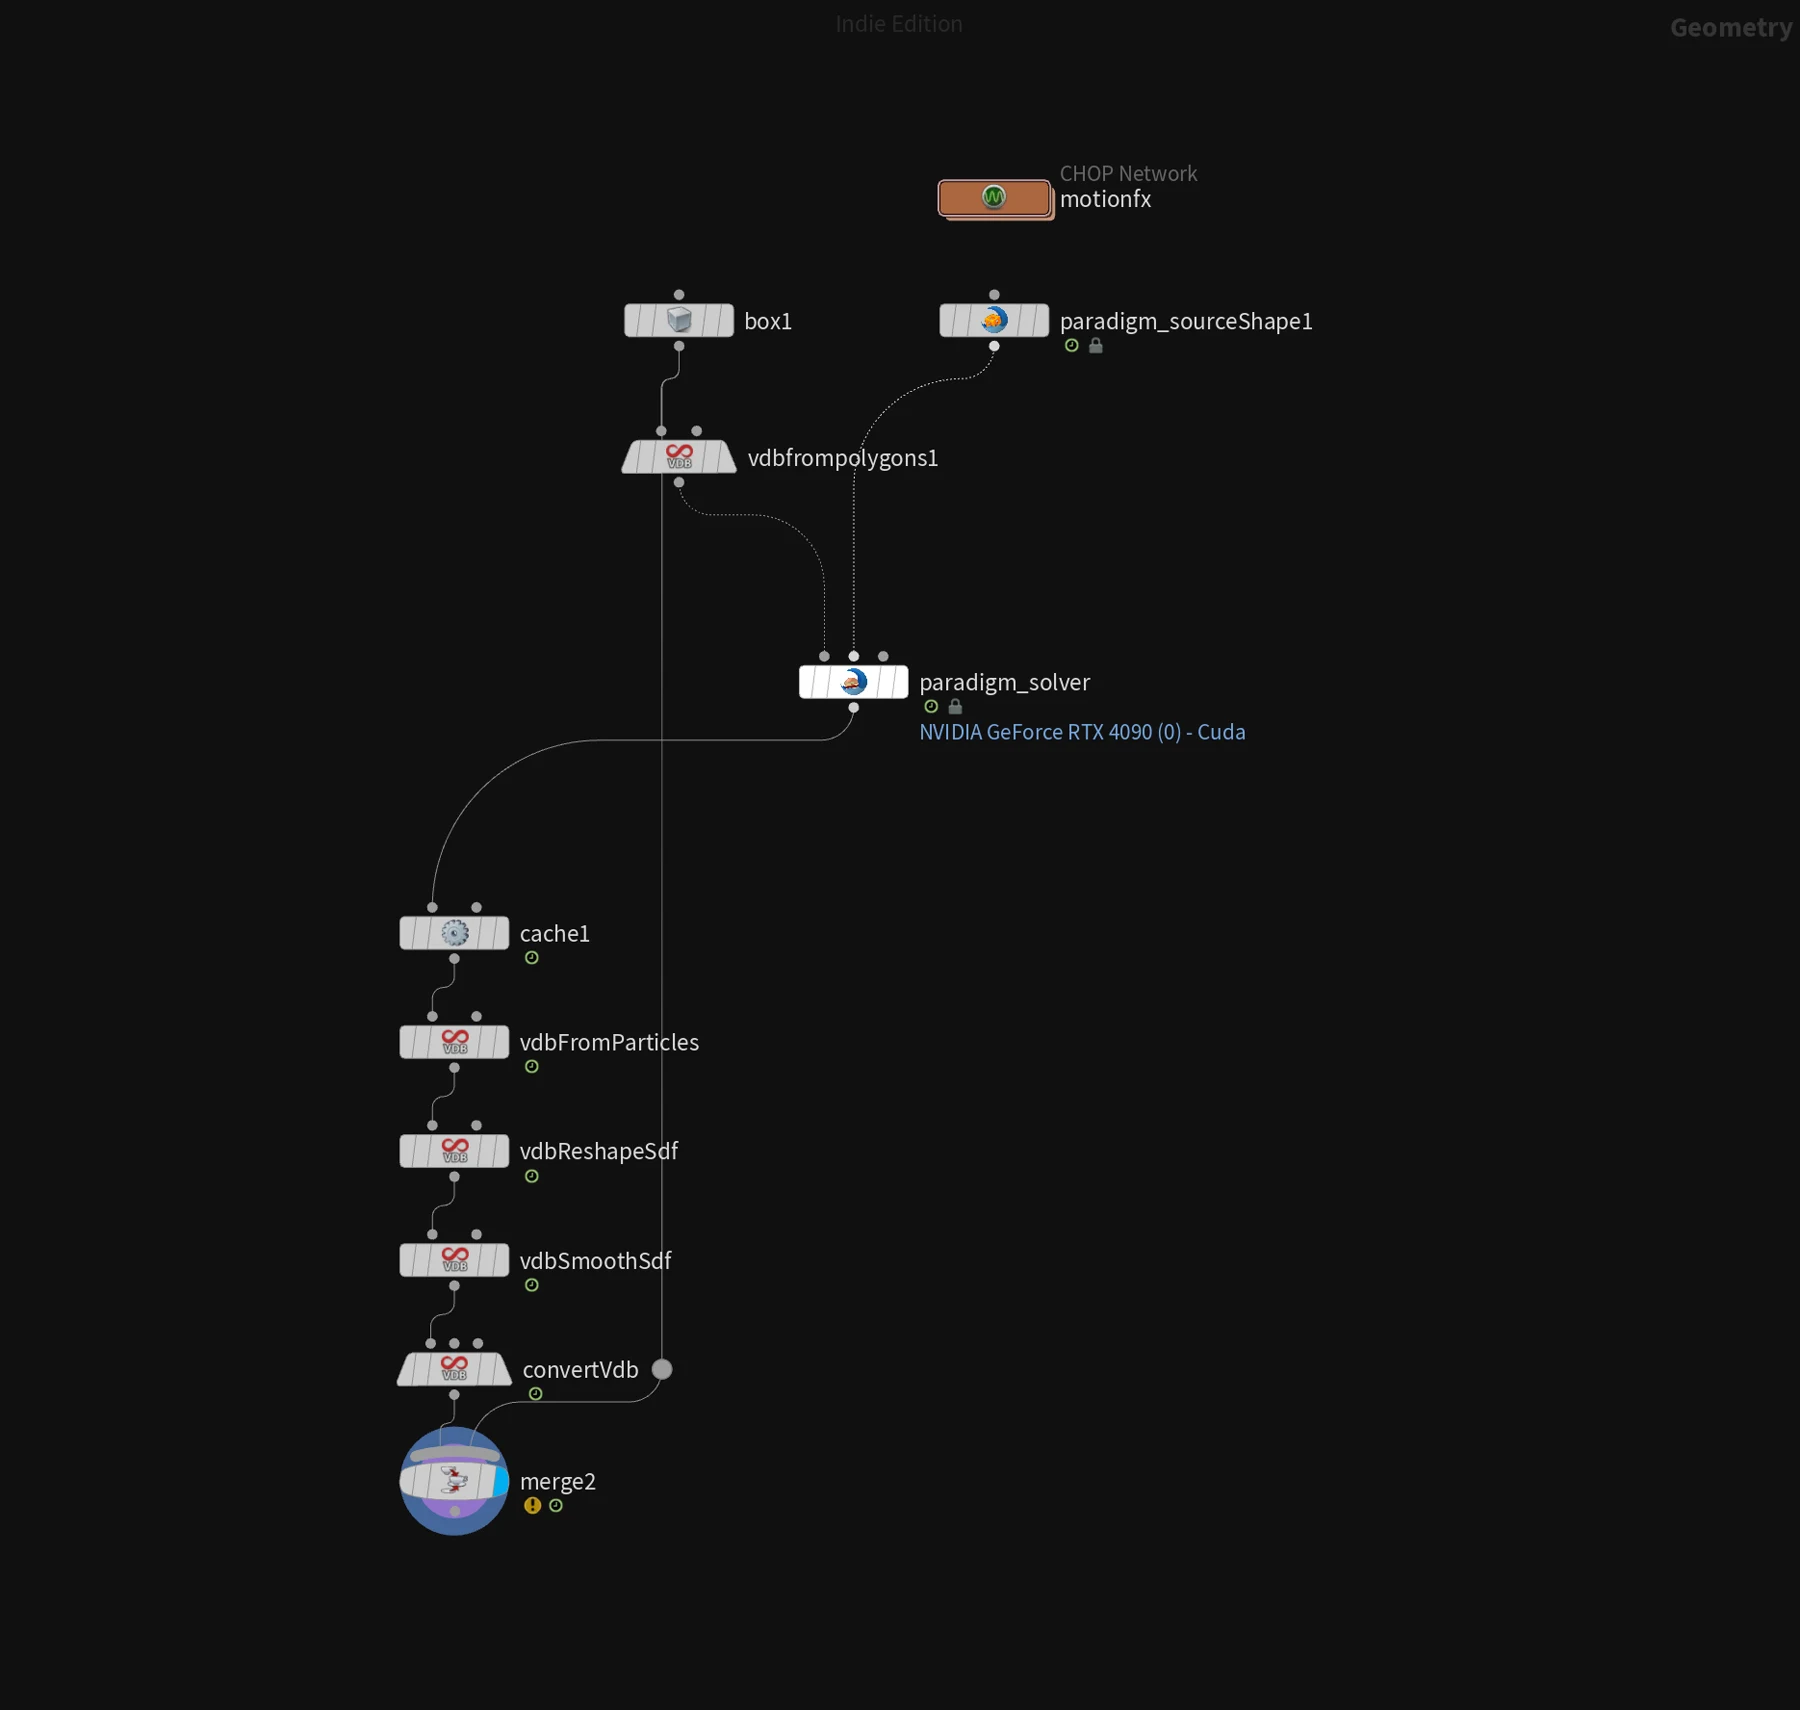
Comecei pelo Houdini e pra deixar tudo mais rápido eu usei o Paradigm. O setup é bem, bem simples, só um emissor, um collider e o solver.
Só precisei ajustar a viscosidade e pronto, o bloco já tava ótimo do jeito que tava, porque ia virar um dadinho de tapioca.
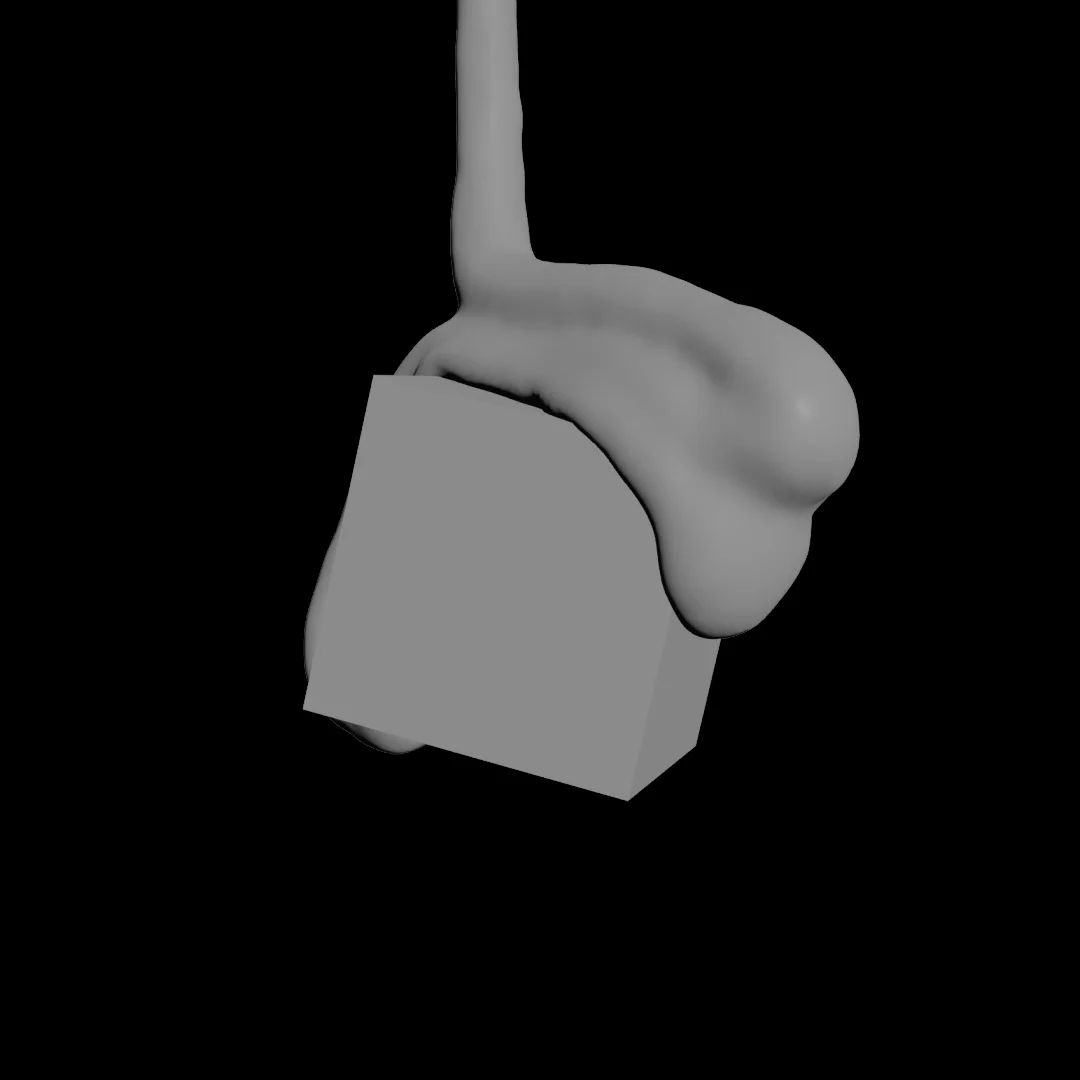
Um print pro chatGPT
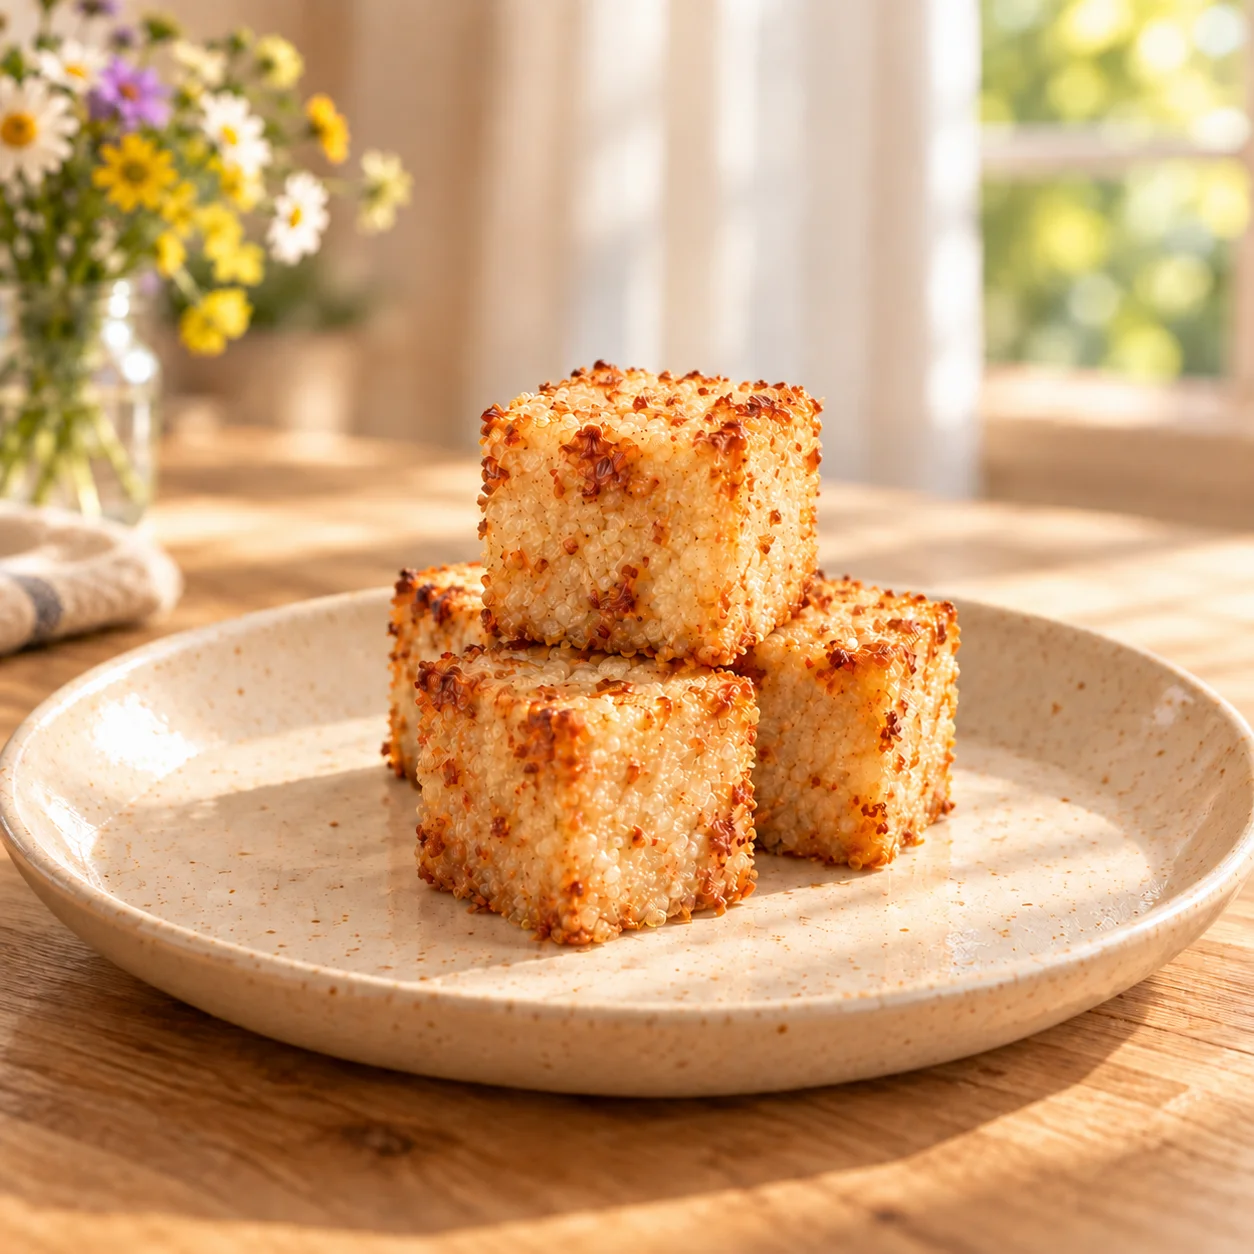
Depois que simulei, tirei um screenshot direto da viewport e mandei pro chatGPT, junto com uma foto real do produto que peguei no Google. Foto amadora mesmo.
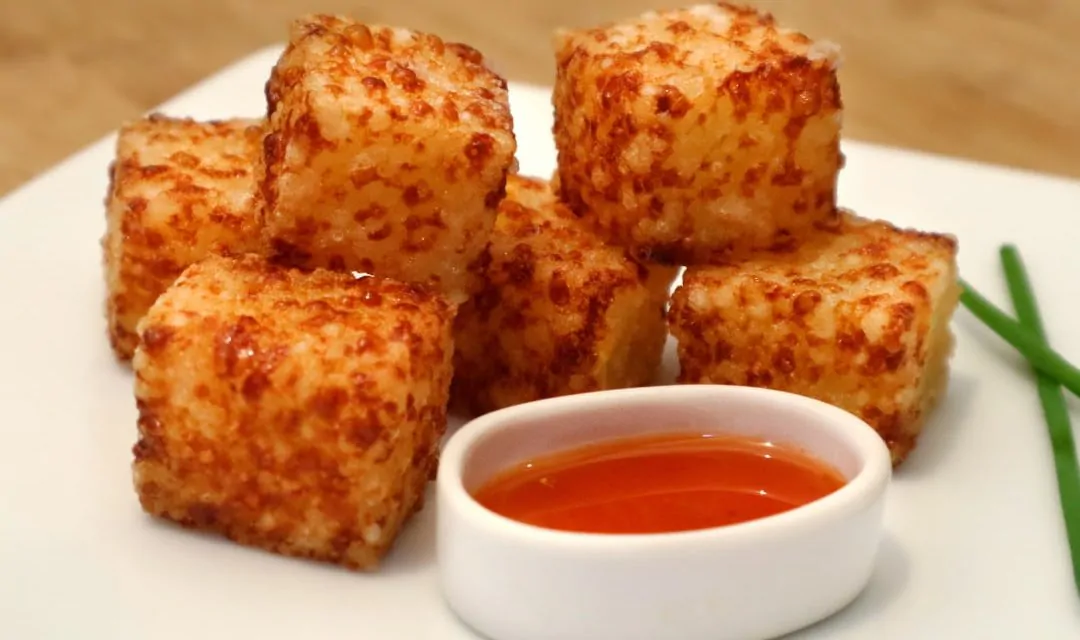
transforma essa imagem em um dadinho de tapioca com um mel apimentado. to te mandando o look que eu queroComfyUI
Aqui eu não tenho muito o que falar. Baixa o ComfyUI e pede pro Claude configurar o que você quer fazer, ele vai achar um workflow que se encaixa. Eu ainda tô estudando o software, é mais complexo do que eu esperava, mas enquanto isso eu vou pedindo pro Claude instalar e me explicar.
Depois de tudo instalado e configurado, foi a hora de entrar na brincadeira.
Os primeiros resultados (horríveis)
Não sei se preciso escrever algo, olhe você mesmo os primeiros resultados. Juro que nessa hora já pensei em parar, que eu tava velho demais pra aprender. O segundo conseguiu vir ainda pior, e no terceiro começou a me dar esperanças.
Nos 2 primeiros eu tinha esquecido completamente de ligar a imagem de referência, ou seja, coisa simples. O 3º teste foi o que chegou mais perto, mas aí descobri que tava faltando algo no meu workflow.
O workflow não reconhecia meu flipbook e pedia um zdepth, que eu não tinha feito pq a ideia era justamente não renderizar nada, pra acelerar o processo e testar coisas diferentes.
Então bora atualizar esse setup e colocar mais um node transformando o vídeo do flipbook num vídeo com depth map.
Agora o setup começou a funcionar.
A cube of toasted bread with a crunchy golden crust, thick golden honey pouring from above and flowing over the cube, warm orange studio background, soft studio lighting, macro food commercial shot. Use the look, materials and colors of <Picture 1>.
Camera: follows the control video exactly.
Audio: none.
Negative: no text / no people / no hands / no extra objects / no flicker
Depois ainda mudei alguns parâmetros e também o prompt, pra que o dadinho tivesse um movimento mais natural.
Tá, mas por que funcionou?
1. O movimento vem do Houdini. O flipbook passa por um node chamado Depth Anything, que transforma cada frame num depth map. E isso te dá muita liberdade depois. Você pode importar no AE e fazer alguma composição, mexer no foco ou fazer uma transição legal com o gradient ramp.
2. O visual vem da imagem do ChatGPT. Ela entra como referência (o “styleframe”), e é dali que o modelo tira a cor, a luz, a textura do dadinho e o brilho do mel.
3. O prompt amarra as duas coisas. Ele descreve a cena em texto e reforça o que a referência já mostra.
Quem junta tudo é o MiniMax H3, um modelo gratuito que gera vídeo a partir de uma imagem de referência, com um ControlNet por cima. O ControlNet é o que faz o vídeo seguir o depth map, frame a frame. Sem ele, a IA inventa o próprio movimento.
E foi no ControlNet que eu achei o controle que faltava. Pra deixar o dadinho com um movimento diferente, mais natural, fui mexendo em dois valores.
strengthé o quanto o vídeo obedece o depth map. Lá em cima ele segue a simulação à risca, mais baixo ele começa a se soltar.end_percenté até que ponto da geração o ControlNet manda. Se você tira ele antes do fim, o movimento principal já tá definido e o gerador ganha um pouco de liberdade pros detalhes.
Baixando um pouco os dois, eu dei mais criatividade pro gerador de vídeo, sem perder a simulação.
Brincando com o setup
Depois fiquei brincando mais um pouco e fiz mais 2 testes, usando o mesmo flip como referência pro movimento e trocando só o styleframe e o prompt. Coisas completamente diferentes saindo da mesma simulação.
No da cadeira eu precisei deixar o H3 mais livre, porque o vídeo de referência não era igual ao styleframe. No 100% ele seguiu o flip à risca, e como o flip é um cubo, a cadeira virou um bloco de madeira haha Então baixei o strength pra 0.7 e o end_percent pra 0.4.
strength 1.0. Virou um cubostrength 0.7, end_percent 0.4A single pixelated, blocky cube head with a low-resolution pixel-art face texture, exactly as in <Picture 1>, floating against a flat, evenly lit pure chroma green background. At the start, the cube is completely clean with no slime on it. Then a thick stream of glossy, translucent pink slime filled with small pink and red heart-shaped glitter enters from above and pours onto the top of the cube, slowly spreading over the edges and folding down its side in soft, viscous layers.
When the slime lands, the cube reacts subtly: it dips slightly under the weight, wobbles gently and slowly settles, with a soft, natural rotation.
Soft, even studio lighting, glossy highlights and subsurface glow in the slime, crisp pixel edges on the cube, product commercial look. Match the look, materials, colors and lighting of <Picture 1>.
Camera: slow cinematic push-in with a gentle floating motion. The control video is a loose guide for composition and motion.
Audio: none.
Negative: no slime on the cube at the start / no shadows or gradients on the background / no green reflections on the cube / no blurry or smoothed pixels / no text / no hands / no extra objects / no flickerA dark walnut wooden chair floating at a slight tilt against a flat, evenly lit pure chroma green background, exactly as in <Picture 1>. At the start, the chair is completely empty and clean. A thick stream of smooth, skin-toned viscous slime pours from above onto the seat. Embedded in the surface of the slime is a serene human face with closed eyes, as if sleeping. The face travels with the flow: it slides down along the falling stream, reaches the seat, glides slowly across it toward the front edge, and droops softly over the edge, always staying intact and part of the slime surface, its features gently stretching and relaxing with the movement of the slime.
When the slime lands, the chair reacts subtly: it dips slightly under the weight, wobbles gently and slowly settles, with a soft, natural rotation.
Soft, even studio lighting, realistic skin texture with subtle subsurface scattering, satin sheen on the slime, natural wood grain on the chair, surreal sculptural look. Match the look, materials, colors and lighting of <Picture 1>.
Camera: slow cinematic push-in with a gentle floating motion. The control video is a loose guide for composition and motion.
Audio: none.
Negative: no slime on the chair at the start / no face appearing already on the seat / no face opening its eyes / no second face / no distorted or melting facial features / no shadows or gradients on the background / no green reflections / no text / no hands / no extra objects / no flickerE aí, usando o mesmo setup de fluido no Houdini, eu só aumentei a quantidade de cubos e segui o mesmo processo.
Nesse caso o modelo não entendia que o mel entrava só depois. Com uma imagem de referência só, o mel já aparecia no prato desde o primeiro frame.
Então tive que dar duas imagens de referência, uma do prato sem mel pro começo e outra com mel pro final.
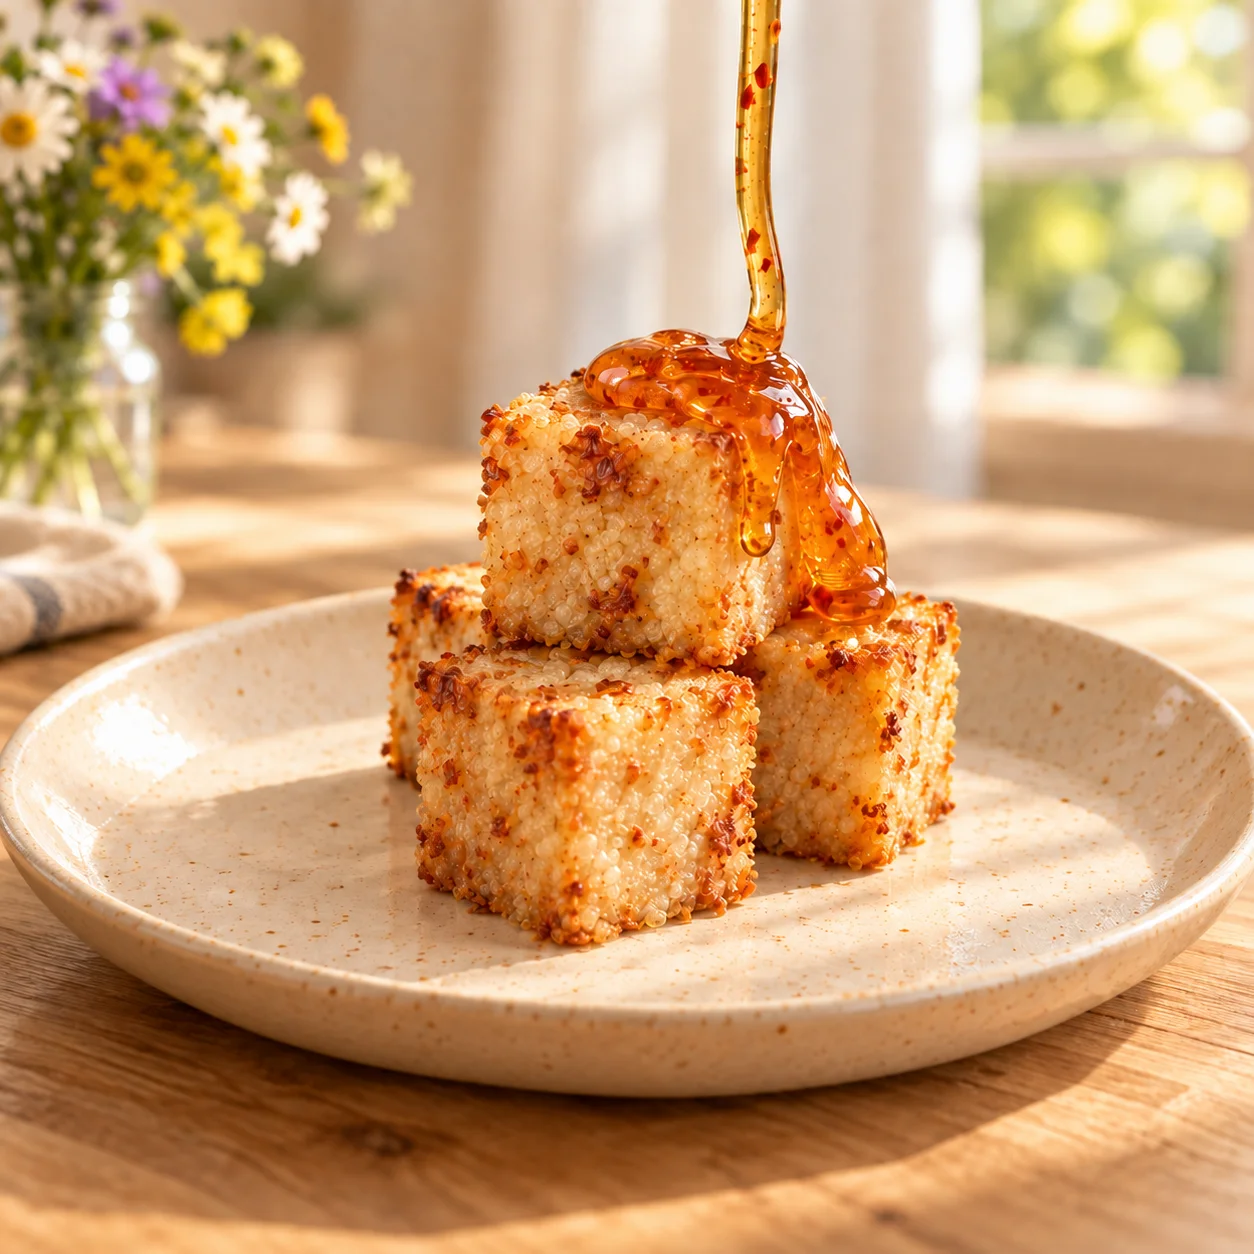
E esse foi o resultado. Pra uma primeira tentativa eu tô satisfeito, mas sinto que dá pra melhorar, principalmente trabalhando mais dentro do 3D e dando uma referência mais redonda do que eu quero.
E o upscale?
Como renderizar em alta tava dando um resultado não tão bom, eu renderizei pequeno e depois precisei aumentar. Testei o SeedVR2, um modelo que roda no próprio ComfyUI, e de cara ele deixou o vídeo todo saturado e estourado. Fui ver e era uma opção só, o color_correction_method tava em none. Coloquei no lab e as cores melhoraram.
Detalhe ampliado. Esquerda: upscale comum. Direita: SeedVR2 com a correção em lab
Também testei mexer no denoise, mas mais atrapalhou do que ajudou. E acima de 2x ele começa a criar uns warps, o vídeo fica meio molengo. Então fica a dica, lab, denoise no padrão e no máximo 2x. O workflow do upscale também tá lá em cima pra baixar.
No final foi só uma passada no After Effects, bobeira, brilho, saturação e um efeitinho de transição bem moderno.
Lições
- Renderiza pequeno e faz upscale depois. Nos meus testes, a resolução menor (
864 × 480) veio com mais qualidade, e depois é só dar upscale. Ficou melhor do que tentar renderizar direto em alta, que vem bem mais aleatório. - O movimento é perfeito. Segue exatamente a simulação, mas você decide se isso é bom ou ruim haha É aí que o seu trabalho na direção é importante, o movimento de câmera, o que acontece na cena… não joga tudo pra IA.
- A iluminação ainda é meio aleatória. Ou, pra ser honesto, eu preciso testar mais pra conseguir controlar.
- Workflow baixado não é workflow que funciona. Passei horas baixando um que não servia pro que eu queria. Melhor entender o que você precisa primeiro.
Se vc for testar esse setup, ou tiver um jeito melhor de controlar esses detalhes, me conta. tmj!
José De Oliveira